nvitop-cluster:一屏看全整个训练集群
Posted on from Haidian, Beijing in Articlesnvitop 很好用,但它只看本机那几张卡。跑 DeepSpeed / torchrun / MPI 多机任务时,我想要的是一屏扫完整个集群——哪台机掉了、哪张卡过热、哪个 rank 卡住不动。于是写了 nvitop-cluster。
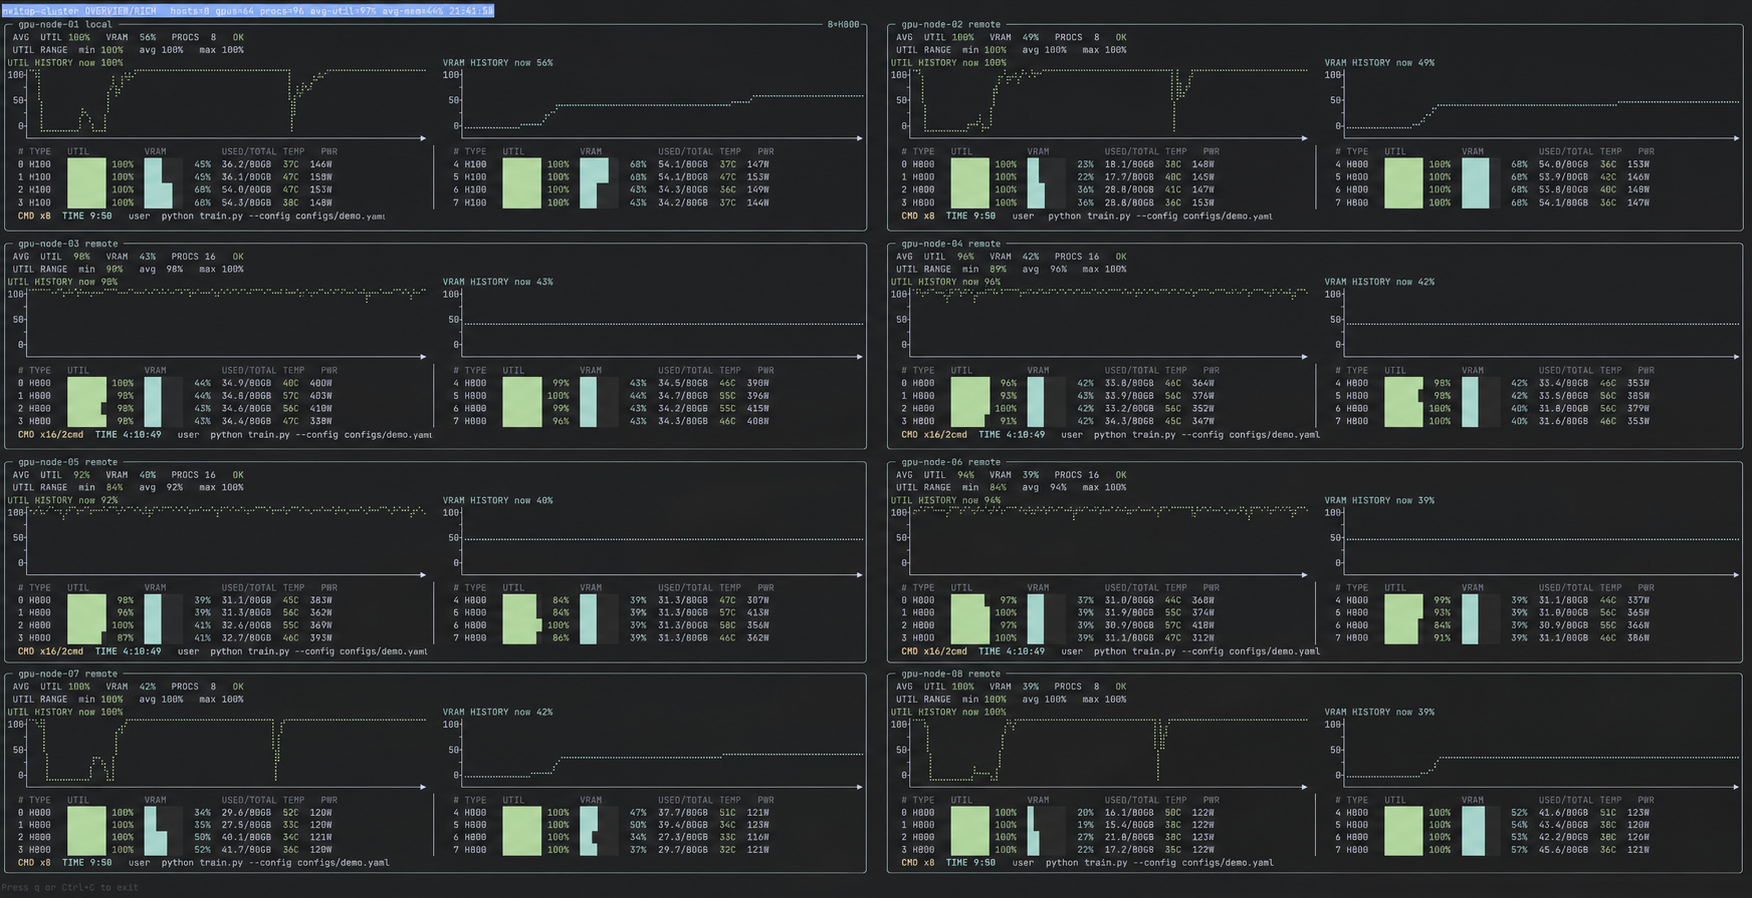
一个 8 机 × 8 卡任务的脱敏截图。小任务用详细的双条视图,机器一多会自动切成这种紧凑的多列总览,保证每台主机都在屏上。
目标很简单:纯标准库、零第三方依赖,pip install 完直接能跑。监控工具自己不该先把一堆依赖装进训练环境。
主机清单复用 hostfile
没有单独维护一份「要监控哪些机器」的清单。工具直接读 MPI hostfile——也就是你 mpirun / torchrun 已经在用的那份。好处是「训练用哪些机器」和「监控哪些机器」天然对齐,不会出现监控清单漏了一台新加的节点这种事。
本机直接 nvidia-smi,远端走 SSH 轮询。为了做到零交互轮询,用了一次性 known-hosts 加 SSH 连接复用(ControlMaster),省掉每轮重连的握手开销。这套只适用于可信的集群内网——不是给你拿去扫公网的。
真正磨人的是布局
翻 commit 历史会发现几乎全是同一个主题在反复折腾:怎么在有限的终端面积里塞下 8 到 16 台主机,还得看得清。
一开始是简单的宽双条,后来加了 Braille 字符画的历史曲线,再后来干脆让它「按终端面积自己决定密度」。最终定在三档:
- COMPACT / RICH / FULL 三种密度,由每张 GPU 能分到的面积自动选。窗口一拉大就自动展开更多细节,拉小就收。
- 历史数据存在有界的内存窗口里,所以你缩放终端、翻页都不会把曲线弄丢。
- 所有主机渲染成等大的卡片网格、支持分页,每张卡上直接显示该 GPU 上进程的命令和已运行时长。
相邻 GPU 如果跑的是同一条命令(多卡训练的常态),会折叠成 CMD ×N 或者 ditto 标记;命令太长就水平滚动。不然满屏都是重复的 python -m torch.distributed...,反而看不出异常。
容器里的进程名是 N/A
一个花了点时间才搞明白的坑:在容器里跑训练时,进程名经常显示成 N/A。
原因是 NVML 报的是宿主机 PID,而 /proc 里只有容器命名空间内的 PID,两边对不上,自然查不到进程名。解决办法是加了个 host→local PID 的映射启发式——按 rank、设备号、RSS 这些线索去匹配,把宿主 PID 还原成容器里能查到的那个。不完美,但大多数情况能把命令还原出来。
从「展示」到「排障」
最后加的一个键我自己用得最多:按 x 只保留需要关注的 GPU——停滞的、过热的、显存打满的、该有进程却没有的。
平时八台机一百多张卡全铺在屏上是「仪表盘」,出问题时按一下 x 把正常的全滤掉,剩下的就是现场。这一下把工具从「给你看」变成了「帮你找」。
几个发布时的小坑
- README 里的截图得先脱敏再放——历史里专门有一次 commit 就是干这个的。
- PyPI 的 README 图片必须用绝对 URL,相对路径在包页面上不显示。
代码在 PyPI:pip install nvitop-cluster。